O que é Inferência de AI? Executando Modelos de IA em Produção
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Atualizado em julho de 2026
Um varejista treina um modelo de previsão de demanda por seis meses. Cientistas de dados o validam. A liderança aprova. O modelo está pronto. Então ele vai para produção e precisa responder milhares de consultas por dia, cada uma em menos de 200 milissegundos, por meses ou anos. Isso é inferência: o processo contínuo e ao vivo de executar um modelo treinado em dados reais para gerar saídas reais.
O treinamento recebe a maior parte da atenção na cobertura de AI. A inferência é onde o valor empresarial realmente existe, e em 2026 também é onde fica a maior parte do orçamento de AI. Os preços de inferência por token caíram ordens de magnitude desde 2022, e o uso cresceu ainda mais rápido, então o gasto total com inferência continua subindo mesmo com o custo unitário diminuindo.
Treinamento vs. Inferência: a distinção fundamental
Entender a inferência requer entender o que ela não é. O treinamento é o processo de ensinar um modelo expondo-o a grandes quantidades de dados e ajustando seus parâmetros até que ele produza saídas precisas. O treinamento é computacionalmente intensivo, caro e realizado com relativamente pouca frequência.

A inferência é o oposto nos três aspectos. É o processo de pegar um modelo cujos parâmetros já estão definidos e executá-lo em novas entradas para gerar previsões. A inferência acontece quando:
- Um cliente digita uma pergunta em um chatbot e recebe uma resposta
- Um sistema de detecção de fraude avalia uma transação em tempo real
- Um pipeline de processamento de documentos extrai dados de uma nota fiscal enviada
- Um motor de recomendações decide o que mostrar ao usuário a seguir
O treinamento acontece uma vez (ou periodicamente). A inferência acontece continuamente, no volume que o sistema de produção exige. Para a maioria das empresas, a inferência é de onde vem praticamente todo o custo de computação de IA em produção.
| Dimensão | Treinamento | Inferência |
|---|---|---|
| Finalidade | Ensinar o modelo ajustando parâmetros com dados históricos | Aplicar os parâmetros fixos do modelo a uma entrada nova, nunca vista |
| Frequência | Acontece uma vez, depois periodicamente para retreinamento ou fine-tuning | Acontece continuamente, toda vez que um usuário ou sistema consulta o modelo |
| Padrão de computação | Computação sustentada, em larga escala e paralela, ao longo de dias ou semanas | Picos curtos por solicitação, repetidos de milhares a bilhões de vezes |
| Formato do custo | Gasto grande, concentrado no início, no estilo de projeto | Gasto contínuo, baseado em uso, que cresce com a adoção |
Um modelo barato de treinar mas caro de rodar em escala ainda pode ser uma má decisão de negócio. Um modelo caro de treinar mas barato de rodar em alto volume pode se pagar muitas vezes. A economia da inferência, e não os benchmarks de treinamento, geralmente decide qual modelo realmente vai para produção.
Como a inferência funciona
Durante a inferência, o modelo treinado recebe uma entrada, seja texto, uma imagem, dados estruturados ou áudio, e a executa por meio de seus parâmetros aprendidos para produzir uma saída. Para um large language model, isso significa que a entrada é convertida em tokens, o modelo processa esses tokens por meio de sua arquitetura transformer usando seus mecanismos de atenção aprendidos, e os tokens de saída são gerados sequencialmente até que a resposta esteja completa. É por isso que respostas mais longas demoram mais para ser produzidas: cada token de saída exige mais uma passagem completa pelo modelo.

Os parâmetros do modelo não mudam durante a inferência. O modelo não está aprendendo com a consulta; ele está aplicando o que já aprendeu à nova entrada. Essa distinção importa na prática: significa que o mesmo modelo pode atender a milhares de usuários simultâneos sem que nenhum afete os outros.
O custo da inferência vem da computação necessária para processar entradas por meio de um modelo que pode ter bilhões ou centenas de bilhões de parâmetros. Mais parâmetros geralmente significa mais capacidade e mais computação por chamada de inferência.
As duas dimensões-chave de desempenho
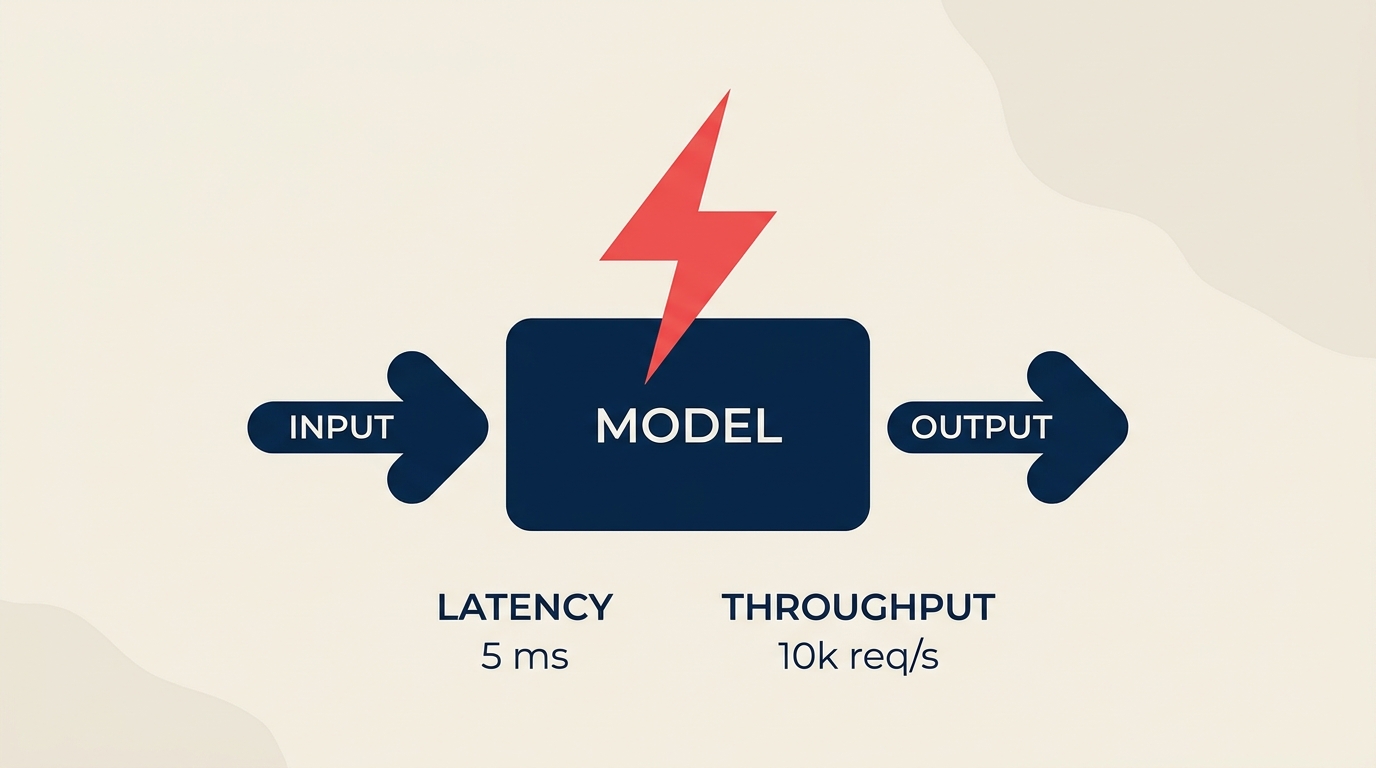
Latência é quanto tempo uma única chamada de inferência leva da entrada à saída. Usuários esperando por uma resposta do chatbot estão experimentando latência. A IA de imagens médicas precisa de baixa latência quando um radiologista aguarda um laudo. O processamento de documentos que acontece de noite em lotes pode tolerar maior latência.

Throughput é quantas chamadas de inferência um sistema consegue processar por unidade de tempo. Um motor de recomendações de e-commerce atendendo milhões de compradores precisa de alto throughput. Uma ferramenta de análise de documentos jurídicos usada por uma equipe de 20 analistas tem requisitos de throughput muito menores.
Essas duas dimensões frequentemente geram trade-offs entre si. Agrupar várias solicitações de inferência juntas, por exemplo, aumenta o throughput, já que o hardware processa muitas entradas em paralelo, mas aumenta a latência para qualquer solicitação individual, pois ela aguarda o lote ser preenchido. O equilíbrio correto depende do caso de uso.
A otimização de inferência é o campo técnico dedicado a melhorar ambas as dimensões, tornando os modelos mais rápidos e econômicos sem sacrificar qualidade.
Onde a inferência roda: nuvem, edge e on-device
A inferência fica no topo do stack de AI. Os modelos de fundação são treinados uma vez por laboratórios de AI usando clusters de computação massivos. As empresas ou chamam esses modelos via API ou implantam modelos em sua própria infraestrutura, e onde essa inferência realmente roda é uma decisão real de arquitetura, não um detalhe a deixar para a equipe de infraestrutura.
Inferência na nuvem. O modelo roda nos servidores de um provedor, normalmente acessado por uma API. Este é o padrão para a maioria das empresas que usam modelos de fundação dos grandes laboratórios. É simples de começar, escala automaticamente com a demanda e mantém o custo atrelado diretamente ao uso. Os trade-offs são o preço contínuo por chamada, a dependência da disponibilidade e das decisões de preço do provedor, e a latência de rede entre a solicitação e o data center.
Inferência self-hosted. A empresa roda o modelo em sua própria infraestrutura de GPU, em uma conta de nuvem privada ou on-premises. Isso dá mais controle sobre a privacidade dos dados, pode ser mais barato do que o preço de API em volumes muito altos e estáveis, e permite personalização mais profunda por meio de fine-tuning. Significa também assumir o peso operacional: provisionar GPUs, gerenciar disponibilidade e lidar com picos de demanda sem a elasticidade de um provedor.
Inferência em edge e on-device. O modelo roda localmente, em um celular, um navegador, um quiosque de varejo ou um sensor industrial, sem nenhuma ida e volta pela rede. É a opção de menor latência e mantém os dados dentro do dispositivo, o que importa para casos de uso sensíveis à privacidade. O trade-off é a capacidade: dispositivos de edge têm memória e computação limitadas, então a implantação em edge geralmente significa um modelo menor e comprimido, e não um de escala de fronteira.
Nenhuma dessas opções é universalmente correta. Um chatbot de suporte ao cliente pode usar inferência na nuvem pela qualidade. Um app de inspeção em campo com conectividade instável pode precisar de inferência em edge para funcionar. Um fluxo de saúde regulado pode exigir inferência self-hosted apenas por questões de residência de dados.
As práticas de MLOps governam como a inferência é gerenciada em produção: como os modelos são versionados e implantados, como o desempenho é monitorado, como reverter quando um modelo se comporta de forma inesperada e quando retreinar. O monitoramento de modelos é a prática contínua de observar as saídas de inferência e as métricas de desempenho para detectar degradação antes que cause impacto nos negócios.
O que mudou em 2026
Durante anos, a conversa sobre AI foi dominada pelo treinamento: modelos maiores, execuções de treinamento maiores, manchetes maiores. Não é mais aí que estão o dinheiro e o risco. A inferência se tornou o centro de gravidade operacional e financeiro da AI em produção, por três razões conectadas.
O uso cresce mais rápido do que o custo por chamada cai. Os preços de inferência caíram drasticamente desde o final de 2022, mas a adoção cresceu ainda mais rápido, então o gasto total com inferência continua subindo mesmo com os custos unitários diminuindo.
A inferência é recorrente, o treinamento não. Uma execução de treinamento é um projeto com começo e fim. A inferência roda durante toda a vida de um recurso implantado, o que para um produto de sucesso pode significar anos. Um custo que parece pequeno por chamada se torna relevante quando multiplicado por milhões de solicitações diárias rodando indefinidamente.
Os provedores de infraestrutura já estão se reorganizando em torno disso. Analistas projetam que as cargas de inferência vão superar o treinamento como a principal demanda sobre os data centers de AI nos próximos anos, e os hyperscalers estão mudando como e onde constroem capacidade em consequência direta: os clusters de treinamento vão para locais remotos e com alta densidade de energia, enquanto a capacidade de inferência se aproxima cada vez mais de onde os usuários realmente estão, para reduzir a latência de rede.
A consequência prática para qualquer líder que patrocina projetos de AI: o modelo que vence o benchmark de treinamento não é automaticamente o modelo que deve ir para produção. O modelo cuja economia de inferência funciona no seu volume real de produção é o que determina se um recurso de AI é um produto sustentável ou um piloto caro.
Fatos principais
- O custo de consultar um modelo com desempenho de nível GPT-3.5 caiu de US$ 20,00 para US$ 0,07 por milhão de tokens entre novembro de 2022 e outubro de 2024, uma queda de mais de 280 vezes em cerca de 18 meses, segundo o relatório Stanford AI Index 2025.
- Os preços de inferência de LLMs em um nível de desempenho fixo caíram a uma taxa mediana de aproximadamente 50x por ano, acelerando para cerca de 200x por ano nos dados a partir de janeiro de 2024, segundo a análise da Epoch AI sobre tendências de preço de inferência.
- Projeta-se que a inferência supere o treinamento como principal carga de computação de AI até 2030, respondendo por mais da metade de toda a computação de AI e por 30 a 40 por cento da demanda total dos data centers, segundo a análise da McKinsey sobre mudanças nas cargas de trabalho de AI.
- 49 por cento das grandes empresas relataram que a maior parte ou quase toda a sua computação é movida por inferência em 2025, contra 29 por cento no ano anterior, segundo a atualização de meio de ano de 2025 do mercado de LLMs da Menlo Ventures.
- Os gastos da Anthropic em 2025 incluíram cerca de US$ 2,7 bilhões em computação de inferência e US$ 4,1 bilhões em computação de P&D (treinamento), de um total de US$ 9,7 bilhões em despesas, segundo a análise da Epoch AI sobre os gastos de empresas de AI, com base em reportagem do The Information.
- Projeta-se que o mercado global de inferência de AI cresça de US$ 106,15 bilhões em 2025 para US$ 254,98 bilhões em 2030, superando o treinamento como principal categoria de despesa em AI empresarial, segundo pesquisa da MarketsandMarkets citada pela Forbes.
O custo empresarial da inferência
Para organizações que usam AI em escala, o custo de inferência é uma linha orçamentária material. Os principais impulsores de custo incluem:

O tamanho do modelo. Modelos maiores exigem mais computação por chamada de inferência. Um modelo de 70 bilhões de parâmetros custa aproximadamente 10 vezes mais para rodar do que um modelo de 7 bilhões, embora as diferenças de qualidade possam justificar o custo para alguns casos de uso.
O volume de solicitações. Os custos de inferência escalam com o uso. Um sistema que processa 10 milhões de chamadas de inferência diárias custa proporcionalmente mais para rodar do que um que processa 10.000.
O hardware. A inferência em GPU é mais rápida mas mais cara do que a inferência em CPU. Chips especializados de inferência (como os TPUs do Google ou o AWS Inferentia) podem melhorar a eficiência de custo para cargas de trabalho específicas.
O tamanho da janela de contexto. Para modelos de linguagem, entradas mais longas custam mais para processar porque o custo de inferência escala com a contagem de tokens. Sistemas que passam grandes quantidades de contexto em cada chamada enfrentam custos proporcionalmente maiores.
Como o custo de inferência escala diretamente com o uso, é o ponto de maior alavancagem para cortar gastos com AI sem mexer no escopo do produto. As principais técnicas de otimização são:
Quantização. Reduzir a precisão numérica dos pesos de um modelo, por exemplo de ponto flutuante de 32 bits para inteiros de 8 ou 4 bits, diminui a pegada de memória do modelo e acelera a computação, geralmente com apenas uma pequena perda de precisão. Veja Quantização para a mecânica.
Destilação. Treinar um modelo "aluno" menor para imitar as saídas de um modelo "professor" maior. O resultado roda mais rápido e mais barato, mantendo a maior parte da capacidade do professor nas tarefas para as quais foi destilado.
Batching. Agrupar várias solicitações de inferência para que o hardware as processe em paralelo, em vez de uma de cada vez. Isso aumenta substancialmente o throughput, ao custo de alguma latência adicional para solicitações individuais, já que cada uma espera o lote ser preenchido.
Caching. Armazenar as saídas de consultas comuns ou repetidas para que o modelo não precise reprocessar a mesma entrada duas vezes. Em aplicações com muito tráfego repetido, o cache pode eliminar uma grande parte das chamadas de inferência.
Decodificação especulativa. Um modelo "rascunho" pequeno e rápido prevê vários tokens à frente, e o modelo maior os verifica em uma única passagem, em vez de gerar cada token um de cada vez por conta própria. Quando os palpites do modelo rascunho são bons, isso reduz o número de passagens completas e caras pelo modelo necessárias para produzir uma resposta.
A maioria dos sistemas de produção combina várias dessas técnicas ao mesmo tempo. Nenhuma delas exige trocar por um modelo fundamentalmente diferente ou de menor qualidade; elas mudam a eficiência com que um modelo existente é servido. Organizações que as aplicam sistematicamente costumam relatar reduções de custo de 50 a 90 por cento em comparação com uma implantação não otimizada.
Inferência em tempo real vs. Inferência em lote
Nem toda inferência acontece em tempo real. Muitas aplicações valiosas de AI rodam em um cronograma de lotes em vez de responder a solicitações ao vivo.
A inferência em tempo real processa solicitações conforme chegam, com latência de milissegundos a segundos. Chatbots, detecção de fraude, personalização em tempo real e assistentes de voz exigem esse modo.
A inferência em lote processa grandes conjuntos de dados em um cronograma, frequentemente à noite ou sob demanda. O enriquecimento de CRM que roda toda noite para pontuar todos os leads, o processamento de documentos que trabalha em uma fila de arquivos enviados, ou as cargas de trabalho de análise que geram relatórios semanais, todas se encaixam no padrão de lote. A inferência em lote é geralmente mais econômica por chamada de inferência porque pode aproveitar estratégias eficientes de agrupamento sem a restrição dos requisitos de latência voltados ao usuário.
A escolha entre os modos é uma decisão de produto e arquitetura, não puramente técnica. Muitos casos de uso que inicialmente parecem exigir inferência em tempo real podem ser redesenhados como quase-em-tempo-real ou em lote sem perda significativa de valor empresarial, a um custo significativamente menor.
O que líderes empresariais precisam entender
Os termos de AI que recebem mais atenção, dados de treinamento, arquitetura do modelo, pontuações de benchmark, todos se relacionam ao potencial de um modelo. A inferência é onde esse potencial se traduz em resultados empresariais ou não. Três consequências práticas decorrem diretamente de como a inferência funciona, e as três pertencem à checklist de um líder antes de aprovar uma implantação de AI, não depois.
O custo escala com o sucesso, o que corta para os dois lados. O custo de treinamento é praticamente fixo depois que o projeto termina. O custo de inferência sobe diretamente com a adoção: quanto mais útil um recurso, mais ele é usado e mais custa para rodar. Um recurso que parece acessível em um piloto com 50 usuários pode virar uma linha de orçamento relevante com 50.000 usuários.
A latência determina se as pessoas realmente usam o recurso. Os usuários adaptam seu comportamento à velocidade com que um recurso de AI responde. Ferramentas interativas que levam mais de alguns segundos costumam perder adoção, e quando os usuários aprendem a contornar um recurso lento, muitas vezes não voltam mesmo depois de ele ser corrigido.
Onde a inferência roda afeta quem pode ver os seus dados. A inferência na nuvem por meio de uma API de terceiros significa que as solicitações, e todo o contexto que contêm, saem do seu ambiente. Para cargas de trabalho regulamentadas ou sensíveis, isso às vezes é inviável, e é por isso que a inferência self-hosted ou em edge existe como alternativa, mesmo com um custo operacional maior.
Ao avaliar fornecedores de AI ou opções de construção, pergunte sobre o custo de inferência por chamada no volume esperado, a latência sob carga real de produção, como o custo de inferência escala com o uso e para onde seus dados realmente vão quando o modelo roda. Esses são os números que determinam se os casos de uso de AI são economicamente sustentáveis.
Conceitos de AI relacionados
- Otimização de Inferência - Técnicas para tornar a inferência mais rápida e econômica
- MLOps - Gerenciando implantação de modelos e pipelines de inferência
- AI de Borda - Executar inferência em hardware local em vez da nuvem
- Monitoramento de Modelos - Rastrear o desempenho da inferência ao longo do tempo
- Latência - Por que o tempo de resposta determina se os recursos de AI são adotados em produção
- Janela de Contexto - Principal impulsador de custo de inferência para modelos de linguagem
- Arquitetura Transformer - Como a maioria dos modelos modernos calcula a inferência
- Quantização - Reduzir o tamanho do modelo para diminuir o custo de inferência
- Large Language Models - A categoria de modelo em torno da qual gira a maior parte da discussão sobre inferência
- Modelos de Fundação - Os modelos base contra os quais as empresas rodam inferência via API ou self-hosting
Recursos externos
- NVIDIA Inference Platform - Infraestrutura padrão da indústria para inferência de modelos em larga escala
- Hugging Face Inference Endpoints - Guia para serving de modelos em produção e trade-offs de inferência
- Google AI Inference Best Practices - Guia prático para arquitetura e otimização de inferência
Perguntas frequentes sobre Inferência de AI
O que é inferência de AI?
A inferência de AI é o processo de executar um modelo de machine learning treinado em novas entradas para gerar previsões ou saídas. É a fase de produção da AI, onde um modelo treinado com dados históricos é aplicado a dados ao vivo para criar valor: respondendo consultas de clientes, pontuando leads, detectando fraudes ou gerando documentos.
Qual é a diferença entre treinamento e inferência?
O treinamento é o processo de ensinar um modelo expondo-o a grandes conjuntos de dados e ajustando seus parâmetros. A inferência é executar o modelo treinado em novas entradas sem alterar esses parâmetros. O treinamento ocorre raramente e requer computação massiva. A inferência ocorre continuamente no volume de produção, que é de onde vem a maior parte do custo contínuo de infraestrutura de AI.
Por que a inferência se tornou mais cara de gerenciar do que o treinamento para muitas empresas?
O treinamento é um custo de projeto único ou ocasional. A inferência é um custo recorrente que escala diretamente com quantas pessoas usam um recurso e com que frequência. À medida que a adoção cresce, o gasto com inferência cresce junto, mesmo com o custo por chamada individual continuando a cair. Vários relatórios do setor de 2025 constataram que a inferência já responde pela maior parte do gasto contínuo com computação de AI, tanto em grandes empresas quanto em startups nativas de AI.
Por que a latência de inferência importa para os negócios?
A latência determina o quão responsiva uma experiência impulsionada por AI parece para os usuários. Aplicações voltadas ao cliente, como chatbots, recomendações em tempo real e assistentes de voz, precisam de baixa latência para evitar frustrar os usuários. Ferramentas internas usadas por funcionários tipicamente têm maior tolerância à latência. Definir corretamente o requisito de latência é uma parte importante das decisões de arquitetura de inferência.
A inferência deve rodar na nuvem ou on-device?
Depende das necessidades de latência, da sensibilidade dos dados e do volume. A inferência na nuvem é a mais simples de implantar e escala automaticamente, o que atende à maioria das aplicações empresariais. A inferência on-device ou em edge elimina a latência de rede por completo e mantém os dados locais, o que importa em casos de uso sensíveis à privacidade ou com conectividade limitada, mas geralmente exige um modelo menor e menos capaz.
A inferência de AI é sempre em tempo real?
Não. A inferência em tempo real responde às solicitações conforme chegam, que é o que chatbots, detecção de fraude e personalização ao vivo precisam. A inferência em lote processa grandes volumes de dados em um cronograma, frequentemente à noite, e costuma ser mais barata por chamada porque não precisa cumprir um requisito de latência ao vivo. Muitas cargas de trabalho que parecem precisar de inferência em tempo real podem rodar em lote ou em quase tempo real, sem perda real de valor empresarial.
Como as organizações podem reduzir os custos de inferência?
As principais alavancas são usar modelos menores onde a qualidade permite, aplicar quantização para reduzir o tamanho do modelo, destilar um modelo menor a partir de um maior, agrupar solicitações onde as restrições de latência permitem, cachear respostas comuns e usar decodificação especulativa em modelos de linguagem. A otimização de inferência é uma disciplina técnica completa; muitas organizações obtêm reduções de custo de 50-90% por meio de otimização sistemática sem trocar o modelo subjacente.
On this page
- Treinamento vs. Inferência: a distinção fundamental
- Como a inferência funciona
- As duas dimensões-chave de desempenho
- Onde a inferência roda: nuvem, edge e on-device
- O que mudou em 2026
- Fatos principais
- O custo empresarial da inferência
- Inferência em tempo real vs. Inferência em lote
- O que líderes empresariais precisam entender
- Conceitos de AI relacionados
- Recursos externos